Agent 上线之后:观测什么,用什么,数据长什么样
一个查不动的现场
用户反馈:「你们这个助手有点慢,问一句要等七八秒。」
你打开日志,看到的是:
POST /api/chat 200 7234ms
然后就没有然后了。这 7 秒花在检索、模型、还是某个工具的超时重试上?日志不告诉你。
这就是 Agent 和普通服务最大的区别:一个请求内部有十几个步骤,但传统日志只记录请求的进出。 中间发生了什么,是一团黑。
可观测性要解决的就是这团黑。但在装工具之前,先要想清楚:你到底想看见什么。
一、四个问题,四组数据
不是所有指标都值得上报。真正需要盯的其实就四类:
| 问题 | 要看的数 | 答案长什么样 |
|---|---|---|
| 延迟 | 每个 span 的耗时,不是整个请求的耗时 | 「检索 1.2s,模型首字 0.8s,生成 4.1s」 |
| 意图识别 | 分类结果 + 置信度 + 命中哪条规则 | 「走的是规则匹配,置信度 1.0」或「模型判成 B,置信度 0.42」 |
| 回复质量 | 引用是否越界、是否拒答、用户是否追问 | 「这条引用了 [3],但只有 2 条资料」 |
| Token 消耗 | 每次调用的输入/输出 token,按 span 聚合 | 「这一步吃了 6800 token,其中 5000 是检索回来的资料」 |
四个问题对应四种不同的数据粒度:
延迟       → 需要 span 级的起止时间
意图识别   → 需要「决策结果」这种业务字段
回复质量   → 需要输出内容 + 判定结果
token      → 需要 token 计数,且要能归到具体某一步
传统 APM(比如只看 HTTP 状态码和总耗时)满足不了后三个——它不知道「模型这一步」是什么。
二、数据模型:四层,一层比一层细
这是所有 LLM 观测工具(LangSmith、Langfuse、LangWatch…)的共识模型,只是叫法略有不同。
User ID        一个人
   │
   └─ Session ID         一次多轮会话(= LangGraph 的 thread_id)
        │
        └─ Trace         一次完整执行(= 一次 invoke)
             │
             └─ Observation   一个具体步骤(= 一个节点 / 一次模型调用 / 一次工具调用)
四层的职责:
| 层 | 回答什么问题 | 对应代码里的什么 |
|---|---|---|
| User | 谁在用,成本花在谁身上 | 你的 userId |
| Session | 这次对话聊了几轮,总共花了多少 | LangGraph 的 thread_id |
| Trace | 这一次请求走通了没有、慢在哪 | 一次 graph.invoke() |
| Observation | 这一步做了什么、吃了多少 token | 一个节点 / 一次 LLM / 一次工具 |
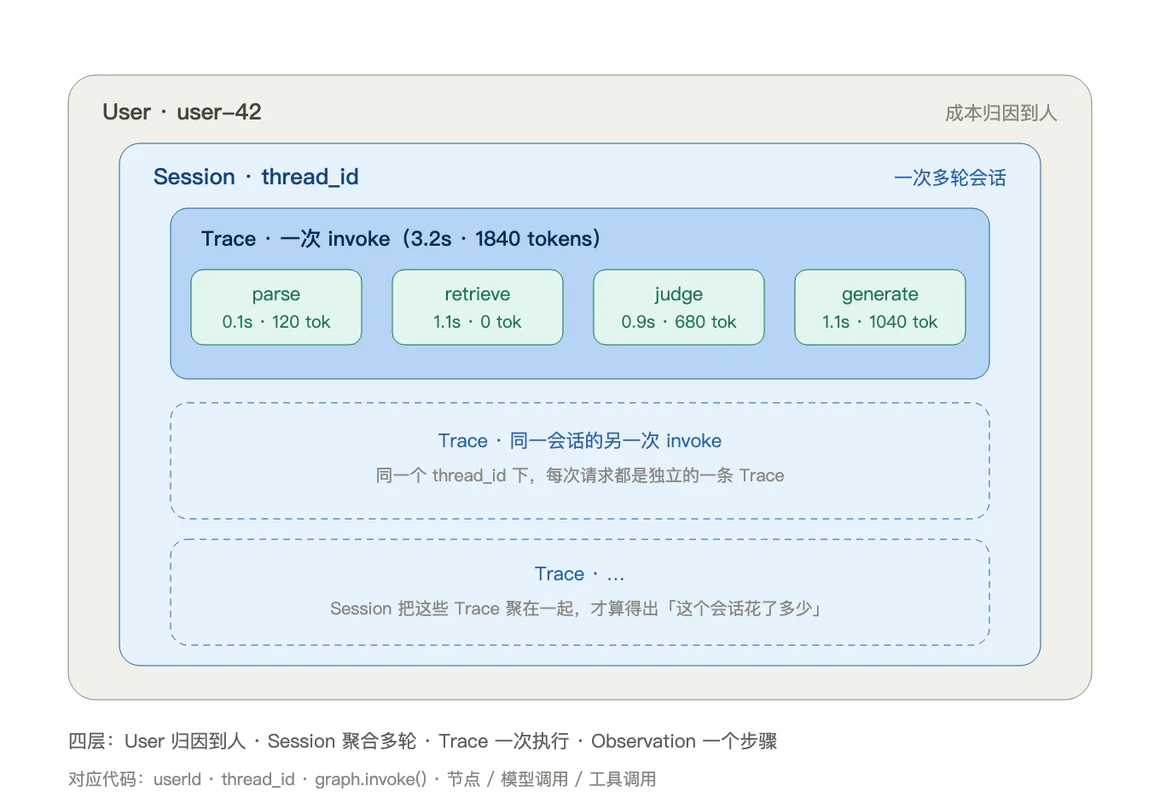
为什么必须分四层,不能只存「请求 + 响应」?
因为排查问题时的顺序永远是从粗到细:
「这个用户最近变慢了」        → 看 User 维度
「是他所有会话都慢,还是某一次」→ 看 Session 维度
「是这一次的哪一步慢」        → 看 Trace 里的 Observation
「这一步到底发了什么」        → 看这条 Observation 的 input/output
少任何一层,你就得靠猜。
三、一次执行到底产生多少条 Observation
这是最容易想当然的地方。我用一个 callback handler 把 LangChain 的 run 树打出来了。
图是 START → parse → query → END,其中 query 节点里调了一个工具 lookup_order:
const query = async () => {
  await lookup.invoke({ id: 'A1' })   // 节点里调工具
  return { n: 1 }
}
挂上 callback 跑一次:
run 总数: 5
根 run(= 一次 trace): 1

根 ─ chain:CompiledStateGraph     id=d3479c  parent=无
   └─ chain:RunnableSequence       id=4b8055  parent=d3479c
   └─ chain:RunnableSequence       id=123300  parent=d3479c
   └─ chain:RunnableSequence       id=f17fa6  parent=d3479c
   └─ tool:DynamicStructuredTool   id=e149e0  parent=f17fa6   ← 挂在某个节点下面
三件事直接读出来了:
① 一次 invoke 只产生一个根 run。 这就是 Trace,不多不少。
② 每个节点都是一个子 run。 2 个节点产生 3 条 RunnableSequence——多出来的一条是 LangGraph 给 __start__ 也包了一层。所以不能假设「节点数 = Observation 数」。
③ 工具调用挂在节点下面,不是挂在根上。 tool:DynamicStructuredTool 的 parent 是 f17fa6(某个节点),不是 d3479c(根)。
第 ③ 条最有价值:它让你能回答「这个工具是谁调的」。如果工具直接挂在根上,你就分不清是哪个节点发起的。
一个完整例子长什么样
同一个 trace 展开,大概是这个形状:
trace: 退票咨询(3.2s,1840 tokens)
├─ observation: parse       0.1s   120 tokens   input: "订单 A1 能退吗"
├─ observation: retrieve    1.1s   0 tokens     input: "退票政策"  output: 3 条切片
├─ observation: judge       0.9s   680 tokens   ← 这一步最贵
│   └─ observation: lookup_order  0.2s
└─ observation: generate    1.1s   1040 tokens
这时候「慢在哪」「贵在哪」一眼就看出来了。 而不是一句「这个接口 3.2 秒」。
四、Observation 里存什么
一条 Observation 的字段,各家工具大同小异。核心是这几个:
| 字段 | 作用 | 排查什么时用 |
|---|---|---|
id |
唯一标识,也是父子关系的连接键 | 追踪调用链 |
name |
这一步叫什么(节点名 / 工具名 / 模型名) | 定位是哪一步 |
type |
类型:llm / tool / chain / retriever / agent |
按类型聚合(比如「所有 LLM 调用的 P95」) |
input |
这一步收到了什么 | 「它到底把什么喂给了模型」 |
output |
这一步产出了什么 | 「检索返回了什么」「模型答了什么」 |
metadata |
自定义键值(用户 ID、意图、版本号) | 按业务维度切片 |
time |
起止时间戳 | 算耗时、看时序 |
environment |
环境:prod / staging / dev | 防止把测试数据混进生产指标 |
这里有两个字段容易被忽略,但很关键:
type 不是装饰。 有了它你才能做「只统计所有 LLM 步骤的 token」这种聚合。没有 type,你只能一条条翻。
environment 决定数据可不可信。 如果压测数据和真实数据混在一起,你的 P95 延迟就没有任何意义。上线前第一件事是给每条上报打上环境标记。
五、两个工具,怎么选
LangSmith:和 LangChain 同源,开箱即用
它是 LangChain 官方做的,最大的优势是零代码接入——只要设三个环境变量:
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY=lsv2_...
export LANGSMITH_PROJECT=my-agent
你现在跑的 graph.invoke() 就会自动上报,一行代码都不用改。对已经在用 LangChain / LangGraph 的项目,这是成本最低的方案。
功能也比「观测」宽得多:
Observability   追踪、监控、洞察
Evals           离线评估、在线评估、数据集、标注队列
Engine          自动聚类失败、定位根因、生成修复建议
Deployment      部署长任务 agent
Sandboxes       给 agent 生成的代码跑沙箱
LLM Gateway     模型网关(限流、降级、PII 脱敏)
关于「能不能自部署」,需要纠正一个说法:
很多人说 LangSmith 不能自部署。准确的说法是——能,但只对 Enterprise 开放,而且是 K8s 部署加 license。
官方文档的原话是:
Self-hosted LangSmith is an add-on to the Enterprise plan designed for LangChain's largest, most security-conscious customers.
所以判断标准不是「能不能」,而是「值不值」:
| 档位 | 价格 | 包含 | 部署 |
|---|---|---|---|
| Developer | $0,限 1 个 seat | 5k traces/月,14 天保留 | 仅 Cloud |
| Plus | $39 / seat / 月 | 10k traces/月,超出按量 | 仅 Cloud |
| Enterprise | 定制 | 定制 | Cloud / 混合 / 自托管 |
两个容易忽略的成本点:
- 一个 agent run 会产生很多条 trace,不是一次请求一条。按 trace 计费时,先算清「每次执行产生几条」。
- 基础 trace 只保留 14 天。一旦加了评估结果或标注,会自动升级到 400 天档,成本翻倍。
结论: 小团队用来开发调试,Developer 档够用;真要长期留存 + 私有部署,就得谈 Enterprise。
Langfuse:开源,自部署友好
Langfuse 是完全开源的(GitHub 上 langfuse/langfuse),一条 docker compose up 就能在本地跑起来。
它的数据模型和上面那四层完全对应:
Traces     一次完整执行
Sessions   多轮会话(可以理解成 thread)
Users      按用户聚合成本和用量
Observations  步骤级明细
它比 LangSmith 多出来的两个实用能力:
① 基于 OpenTelemetry。 这意味着不绑定框架——LangChain、LlamaIndex、自己手写的循环,都能通过 OTEL 接入。以后换框架,观测数据不用重做。
② 自带 Prompt 管理和数据集。 可以在平台上改提示词、打标签发版、跑对比实验,不用改代码。
接入方式(LangChain 场景):
import { CallbackHandler } from "@langfuse/langchain"

const handler = new CallbackHandler({
  publicKey: process.env.LANGFUSE_PUBLIC_KEY,
  secretKey: process.env.LANGFUSE_SECRET_KEY,
  baseUrl: process.env.LANGFUSE_BASE_URL,   // 自部署时填自己的地址
})

await graph.invoke({ question }, { callbacks: [handler] })
注意这是「挂 callback」,不是零代码。 每个入口都要记得挂——漏挂的那条链路就是观测盲区,而且你很难发现漏了。
所以实际项目里的做法是在统一入口处挂一次:
// 所有图执行都走这个函数,避免有人忘了挂
export async function runGraph(graph, input, config) {
  return graph.invoke(input, {
    ...config,
    callbacks: [...(config.callbacks ?? []), handler],
  })
}
怎么选
| 你的情况 | 建议 |
|---|---|
| 已经在用 LangChain / LangGraph,想最快看到数据 | LangSmith(三个环境变量搞定) |
| 数据不能出内网 | Langfuse 自部署,或者 LangSmith Enterprise |
| 以后可能换框架 | Langfuse(OTEL 是解耦层) |
| 需要 Prompt 版本管理 + 数据集实验 | Langfuse 更顺手 |
| 需要「自动找失败原因、给修复建议」 | LangSmith Engine |
一个务实的选择:开发期用 LangSmith(省事),上线后如果成本或合规卡住,再迁到 Langfuse。 因为两边的数据模型是同一套,迁移主要是换上报 SDK,不改业务代码。
六、上报时机:为什么是「节点」,不是「请求」
提纲里那句「上报时机是 runnable(节点)」,值得展开说。
如果只在请求进出时上报,你拿到的是:
请求开始 09:00:00.000
请求结束 09:00:07.234
总计 7234ms
如果在每个节点上报,你拿到的是:
09:00:00.000  parse      开始
09:00:00.120  parse      结束  120ms
09:00:00.130  retrieve   开始
09:00:01.230  retrieve   结束  1100ms    ← 慢在这
09:00:01.240  judge      开始
09:00:02.140  judge      结束  900ms
09:00:02.150  generate   开始
09:00:07.230  generate   结束  5080ms
差别不是「更细」,而是「能定位」。 前者只能告诉你「慢」,后者告诉你「生成慢,而且 judge 那步也贵」。
上报的时机有两个点,缺一不可:
节点开始  → 记录 input、startTime
节点结束  → 记录 output、endTime、token 用量、是否报错
只有开始没有结束,你就不知道这一步是「还在跑」还是「挂了」——这是排查卡死问题的关键信息。
上报什么数据
三个必填,一个强烈建议:
必填:input、output、metadata
建议:usage(token 数、模型名、单价)
metadata 里放什么,决定了这套观测能不能回答业务问题。建议至少放这四个:
metadata: {
  userId,              // 归因到人
  intent,              // 意图识别的结果(回答「意图识别准不准」)
  promptVersion,       // 提示词版本(改了之后效果变了能对比)
  environment,         // prod / staging
}
promptVersion 这个字段特别值钱。 没有它,你改了一版提示词,效果变差时无法判断「是这次改动导致的,还是模型本来就波动」。
七、回到那四个问题
现在再看开头那个「有点慢」:
| 问题 | 现在怎么回答 |
|---|---|
| 延迟 | 按 Observation 拉时间轴,直接看出是 retrieve 1.1s 还是 generate 5.1s |
| 意图识别 | 按 metadata.intent 聚合:哪些意图的置信度低于 0.6,占多少 |
| 回复质量 | 挂评估:引用是否越界、是否拒答、用户有没有追问 |
| Token | 按 type=llm 聚合 token,按 Session 算人均成本 |
四组数据对应的动作也不同:
延迟高      → 优化那一步(换模型、加缓存、并行)
意图识别差  → 补规则 / 改分类提示词 / 加澄清
质量差      → 改检索、加校验、调提示词
token 高    → 砍上下文、换小模型、加摘要压缩
没有观测的时候,这四个问题都只能靠猜,而猜错的代价是改错地方。 我见过最常见的浪费是:延迟高就换模型,结果换完发现瓶颈在检索的一条慢查询上。
八、三条可以直接带走的
- 四层模型别省层。 User / Session / Trace / Observation,缺哪层,排查时就得手工拼。LangGraph 的
thread_id天然就是 Session。 - 上报粒度是节点,不是请求。 节点开始和结束都要报,只报开始你分不清「在跑」和「挂了」。
type和environment这两个字段,一个决定能不能聚合,一个决定数据可不可信。 上线前先把环境标好。
最后一句:观测不是为了「有数据」,是为了「改对地方」。 如果一套观测装完,你排查问题的路径没变短,那它只是增加了存储成本。