LangGraph 的 checkpoint:图跑到一半崩了,凭什么能接着跑
先说它解决什么
一个任务跑了 6 步,第 7 步的时候进程重启了。
没有 checkpoint 的话:用户得从头说一遍,前面 6 步的外部调用全部重做。如果第 3 步是「已经扣了款」,那就更麻烦。
checkpoint 就是给图拍的快照。 每一步结束存一份,崩了从最近一份接着跑。
但这句话里藏着三个需要说清的问题,也是这篇要答的:
多久存一次?        → 粒度是「超步」,不是「节点」
每份多大?存什么?  → 一张图的状态快照,六个字段
存在哪?            → LangGraph 不管,checkpointer 管
一、粒度:以「超步」为单位
LangGraph 的执行模型借自 Google 的 Pregel:一批节点同时跑,全部跑完后统一更新状态。这一批就叫一个超步(superstep)。
所以 checkpoint 的切分依据是「超步」:
一个超步结束 → 存一次。超步里有几个节点,不影响存几次。
实测一:串行 4 个节点,产生了 6 个 checkpoint
图是 START → parse → query → judge → finish → END,每个节点只做一件事(n = n + 1)。
const g = new StateGraph(State)
  .addNode('parse', mk('parse'))
  .addNode('query', mk('query'))
  .addNode('judge', mk('judge'))
  .addNode('finish', mk('finish'))
  .addEdge(START, 'parse')
  .addEdge('parse', 'query')
  .addEdge('query', 'judge')
  .addEdge('judge', 'finish')
  .addEdge('finish', END)
  .compile({ checkpointer: new MemorySaver() })
跑一次,然后用 getStateHistory 把历史全捞出来:
=== checkpoint 总数:6 ===

step= 4  next=[]            n=4
step= 3  next=["finish"]    n=3
step= 2  next=["judge"]     n=2
step= 1  next=["query"]     n=1
step= 0  next=["parse"]     n=0
step=-1  next=["__start__"] n=0
4 个节点,6 个检查点。 多出来的两个是:
| step | 是什么 |
|---|---|
-1 |
输入刚写进去(metadata.source = "input") |
0 ~ 3 |
每个超步结束各一份(source = "loop") |
4 |
全部跑完,next 为空 |
所以不用记公式,记住**「输入算一份,每步一份,结束算一份」**就够了。
实测二:两个节点并行,只有 4 个 checkpoint
换成 START 同时连到 A 和 B,A、B 都完成后进 C:
.addEdge(START, 'A')
.addEdge(START, 'B')     // A 和 B 同时启动
.addEdge('A', 'C')
.addEdge('B', 'C')       // 两个都完成才进 C
A、B 各 sleep 200ms。实测:
=== A 与 B 各耗时 200ms,同时启动 ===
  > A 完成
  > B 完成
  > C 完成
总耗时: 230 ms  → 并行(若串行应 ≥400ms)

checkpoint 总数: 4
  step= 2  next=[]           id=1f1cf8a9-e969-6060-8002-b6d9cc001307
  step= 1  next=["C"]        id=1f1cf8a9-e949-6490-8001-6fec9d88de86
  step= 0  next=["A","B"]    id=1f1cf8a9-e757-63d0-8000-ecf0697159f1
  step=-1  next=["__start__"] id=1f1cf8a9-e748-6970-ffff-094bab2c32b4
看 step=0 的 next:["A","B"]。 两个节点在同一条记录里,因为它们属于同一个超步。
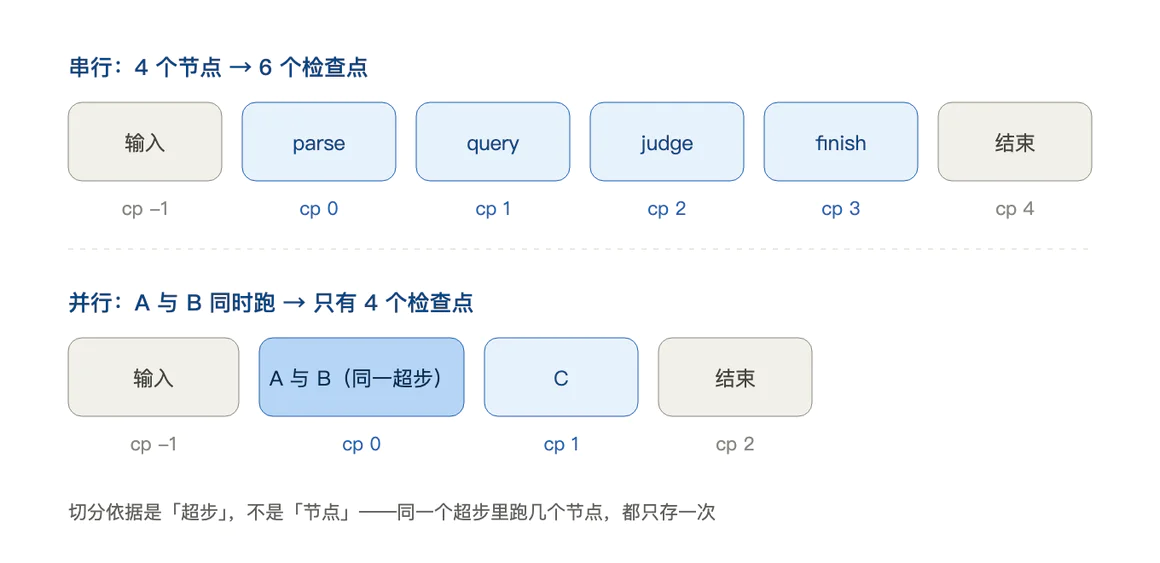
这个设计有个直接的好处:恢复时的粒度是「一批」,不是「一个」。 如果 A 成功、B 失败,恢复到超步 0 会两个都重跑——所以节点要能重复执行(这就是为什么上一篇文章里反复强调幂等)。
一个副作用:超步是并发的边界
同一超步里的节点看不到彼此的结果。A 改了状态,B 在这轮读到的还是旧值,两者在超步结束时才合并。
这解释了一个常见困惑:为什么我在 A 里写的数据,B 读不到? 因为它们同时执行。要依赖,就加一条边,让它们落在不同超步。
二、checkpoint_id:自动分配,而且能串成链
每产生一份 checkpoint,框架自动分配一个 id,形如:
1f1cf8a9-e748-6970-ffff-094bab2c32b4     ← step -1
1f1cf8a9-e757-63d0-8000-ecf0697159f1     ← step 0
1f1cf8a9-e949-6490-8001-6fec9d88de86     ← step 1
1f1cf8a9-e969-6060-8002-b6d9cc001307     ← step 2
你不用自己维护序号。 三个可直接观察到的性质:
| 性质 | 证据 | 有什么用 |
|---|---|---|
| 同一批生成的 id 前缀相同 | 四个都是 1f1cf8a9- |
能看出它们属于同一次执行 |
| 时间上递增 | e748 → e757 → e949 → e969 |
按 id 排序 ≈ 按时间排序 |
| 不是内容哈希 | 状态相同也会生成新 id | 每次执行都是新记录,不会覆盖 |
链是怎么串起来的
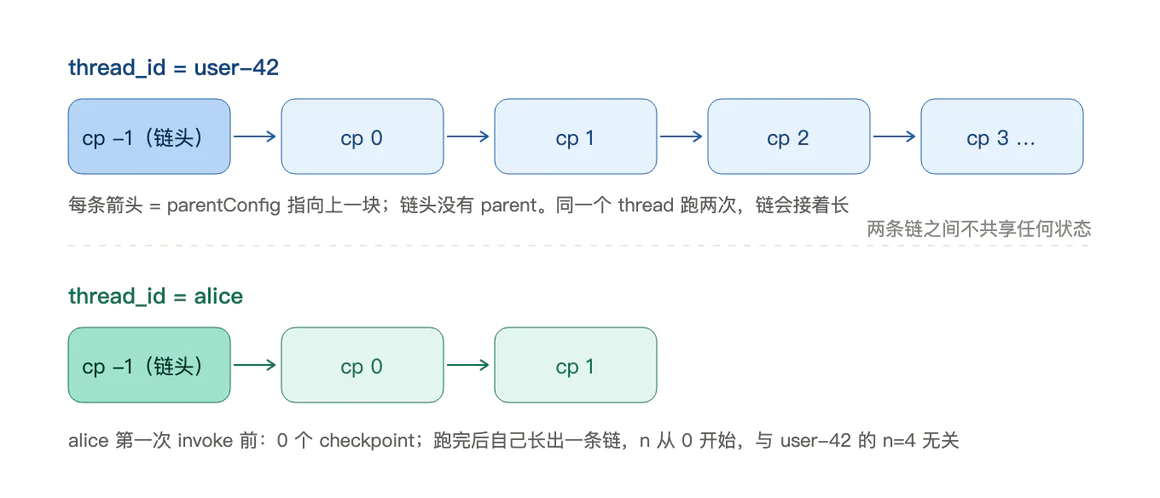
每份 checkpoint 的 config 里带 checkpoint_id,而 parentConfig 指向上一个:
{
  config: { configurable: { thread_id, checkpoint_ns, checkpoint_id: '1f1c...' } },
  parentConfig: { configurable: { ..., checkpoint_id: '1f1c...(上一份)' } }
}
链头的 parentConfig 是 undefined。
这条链就是「时间旅行」的实现基础:想回到第 2 步,就是拿到那个 id,从它 fork 一条新分支重跑。
一个容易踩的坑:checkpoint_id 不在 config 顶层
我第一次写代码时这么取的:
s.config.checkpoint_id          // ❌ undefined
s.config.configurable.checkpoint_id   // ✅ 1f1cf8a9-e748-...
config 的结构是 { configurable: { thread_id, checkpoint_ns, checkpoint_id } },id 埋在 configurable 里面。取错了不报错,只是拿到 undefined。
三、thread:不是线程,是把 checkpoint 串起来的绳子
这个名字坑了不少人。thread 跟操作系统的线程没有任何关系。
thread_id是一个标识符,用来回答「这些 checkpoint 属于同一次对话/同一个任务」。
它就是个普通的配置项:
const config = { configurable: { thread_id: 'user-42' } }
await graph.invoke({}, config)
实测三件事:
① 同一个 thread 跑第二次,会接着上次的状态走。
=== 同一 thread 第一次 invoke ===
结束时 n = 2

=== 同一 thread 第二次 invoke(不传初始值)===
结束时 n = 4   ← 从上次的结果继续,不是从 0 开始
② 链会接着长,step 是 thread 级累加,不是单次 invoke 重置。
step=-1  n=0   ← 第一次的输入
step= 0  n=0
step= 1  n=1
step= 2  n=2   ← 第一次结束
step= 3  n=2   ← 第二次开始(step 从 3 继续,不是回到 0)
step= 4  n=2
step= 5  n=3
step= 6  n=4   ← 第二次结束
③ 换一个 thread,是彻底独立的一条链。
alice 的 checkpoint 数: 0 (全新,互不可见)
alice 跑完后 n = 2
user-42 的 n 不受影响: 4
所以 thread 是什么,一句话
node(节点)      = 干什么
edge(边)        = 下一步去哪
checkpoint(检查点)= 走到这一步时的样子
thread(会话)    = 这些检查点属于谁的那一次任务
别把它当线程用。 同一个 thread 的并发 invoke 会互相干扰(都基于同一份最新状态继续),要并行就开不同的 thread_id。
四、checkpoint 里到底存了什么
把最早那份 checkpoint 完整打出来:
{
  "values": { "n": 0, "log": [] },
  "next": ["__start__"],
  "tasks": [
    {
      "id": "4682d185-e9e7-542f-abbc-56e4e21cbdd1",
      "name": "__start__",
      "path": ["__pregel_pull", "__start__"],
      "interrupts": []
    }
  ],
  "metadata": {
    "source": "input",
    "step": -1,
    "parents": {},
    "thread_id": "T-100"
  },
  "config": {
    "configurable": {
      "thread_id": "T-100",
      "checkpoint_ns": "",
      "checkpoint_id": "1f1cf8a8-cb2c-6a80-ffff-e1dd38eb02ed"
    }
  },
  "createdAt": "2026-10-24T09:08:59.816Z"
}
六个字段,各管一件事:
| 字段 | 存什么 | 谁在读它 |
|---|---|---|
values |
你的 State 全部字段的值 | 节点函数读它;恢复时用它重建状态 |
next |
下一步要执行哪些节点 | 续跑全靠它——从 next 里的节点开始 |
config |
thread_id + checkpoint_id + checkpoint_ns |
定位这一份是谁的、编号多少 |
metadata |
source(input/loop)、step、thread_id |
调试、排历史、找第几步 |
tasks |
待执行任务的 id、名字、路径、interrupts |
人审断点就藏在 interrupts 里 |
createdAt |
生成时间 | 排查「这份是什么时候的」 |
三个容易忽略的点
① next 为空意味着「跑完了」。
step= 4 next=[] ← 没有下一步,流程结束
判断一个任务是否结束,看 next 比看别的字段都直接。
② metadata.step 从 -1 开始。
-1 是输入,0 是第一个超步开始前。不要用 step >= 0 过滤,会把输入的 checkpoint 丢掉。
③ tasks[].interrupts 非空 = 这里有个人工闸门。
上一篇文章里 interrupt() 暂停之后,__interrupt__ 里的内容就挂在当前 checkpoint 的 tasks 上。所以「人审」不是另外存了一份待办,它就是 checkpoint 的一部分。
五、存在哪:LangGraph 不管,checkpointer 管
这是最需要说清的一层分工:
LangGraph 只负责「生成 checkpoint」,不负责「放在哪」。存储格式、位置、生命周期,全由你挂的那只 checkpointer 决定。
换 checkpointer 就是换存储,图的代码一行不用改:
new StateGraph(State) /* ... */ .compile({ checkpointer })
                                      // ↑ 只有这里不一样
官方提供的实现
| 实现 | 包 | 存在哪 | 适合 |
|---|---|---|---|
MemorySaver |
内置 | 进程内存 | 开发调试、单次演示 |
SqliteSaver |
@langchain/langgraph-checkpoint-sqlite@1.1.0 |
本地 .db 文件 |
单机部署、CLI 工具 |
PostgresSaver |
@langchain/langgraph-checkpoint-postgres@1.1.2 |
Postgres 表 | 多实例生产环境 |
| 自定义 | BaseCheckpointSaver |
你自己定(Redis、MySQL、S3…) | 已有基础设施、特殊合规要求 |
很多人以为只有「内存 / SQLite / 自定义」三种,其实 Postgres 是官方正式维护的第四种,而且多实例场景基本只能选它。
MemorySaver 的边界必须知道
进程不重启 → 能续跑
进程一重启 → 全没了,跟没存一样
多实例     → A 机器存的,B 机器查不到
它只在「同一个进程内」有效。 压测时发现不了这个问题,因为单进程一直活着;上线后多实例 + 滚动发布,用户第二次请求打到另一台机器,会话就丢了。这个 bug 是随机的,最难查。
自定义要实现什么
继承 BaseCheckpointSaver,五个抽象方法(JS 版,@langchain/langgraph-checkpoint 1.2.1):
| 方法 | 作用 |
|---|---|
getTuple(config) |
取一份 checkpoint 及其待写入 |
list(config, options) |
列出一个 thread 的所有 checkpoint(异步生成器) |
put(config, checkpoint, metadata, newVersions) |
写一份,返回带新 checkpoint_id 的 config |
putWrites(config, writes, taskId, taskPath?) |
存中间写入(同一超步内各节点的输出) |
deleteThread(threadId) |
删掉整个 thread |
两个容易做错的地方:
① put 必须返回新的 config。 框架靠这个返回值拿到刚生成的 checkpoint_id,后续的 parentConfig 就指它。返回 void 会让链断掉。
② putWrites 的顺序不能乱。 同一个超步里多个节点的写入,如果 reducer 是有序的(比如拼接数组),回放顺序错了会重建出不同的值。源码注释里明确要求按 writesSortKey(task_path, task_id, idx)返回。
选型建议
本地开发           → MemorySaver
单机、小工具        → SqliteSaver
生产、多实例        → PostgresSaver
已有 Redis/MySQL   → 自定义(但先想清楚:值不值得)
「自定义」看起来最灵活,实际成本最高。 你要自己处理序列化(serde)、并发写、清理策略、迁移。除非有明确的合规或性能要求,否则先别自己写。
六、五个常见坑
① 没绑 checkpointer,图照样跑,只是不存。
.compile() // 没有 checkpointer
不报错,invoke 正常返回,但 getStateHistory 是空的、interrupt 无法恢复。「跑通了」和「能续跑」是两件事。
② thread_id 拼错,等于新建一个会话。
最常见的是拿 requestId 当 thread_id——每次请求都不同,于是永远是全新会话,永远续不上。
③ 用 MemorySaver 上了多实例。
见上一节。
④ 期望「恢复到出错的那一个节点」。
实际粒度是超步。一个超步里 3 个节点,失败了会 3 个都重跑。节点必须可重入。
⑤ 状态里放了不该持久化的东西。
values 是整份存下来的,不是增量。往 State 里塞一个 10MB 的文件内容,每一步都会存一遍——存储和序列化开销立刻爆炸。
State 里只放「恢复时需要的东西」。 大对象放外部存储,State 里存 key。
七、一张图总结
用户请求
   ↓  thread_id = "user-42"
[输入]  → cp -1  (source=input)
   ↓
[超步 0: parse]        → cp 0   next=["query"]
   ↓
[超步 1: query]        → cp 1   next=["judge"]
   ↓
[超步 2: judge]        → cp 2   next=["approve"]
   ↓
[超步 3: approve]      → cp 3   next=["execute"]  ← interrupt 挂在这里
   ↓  Command({ resume }) 从 cp 3 继续,不重跑前面
[超步 4: execute]      → cp 4   next=[]
   ↓
 结束
四条可以直接带走的结论:
- 粒度是超步:一批节点一次,不是一节点一次。并行不增加份数,但会放大重跑的范围。
- id 自动生成,
parentConfig串成链——不需要自己维护序号,但取 id 要走config.configurable.checkpoint_id。 thread不是线程,是「这堆 checkpoint 属于谁」。同 thread 续跑、异 thread 隔离、step按 thread 累加。- LangGraph 只生成不存储,存哪由 checkpointer 定。
MemorySaver只能用于开发,生产上 Postgres 或自定义。