AI Agent 核心架构模式全解析:从原理、流程图到JavaScript实战代码
引言
本文将基于经典的AI Agent架构范式,结合手写笔记中的核心设计,详细拆解4种主流架构模式,配套可直接复用的Mermaid流程图、开箱即用的JavaScript(Node.js)实战代码,同时分析各架构的优缺点与适用场景,帮助你从0到1理解并落地AI Agent。
本文代码基于OpenAI GPT模型实现,兼容Node.js环境,所有代码均可直接运行,只需替换自己的API Key即可。
前置环境准备
所有代码示例均基于以下依赖,先执行安装命令:
# 安装核心依赖
npm install openai dotenv
在项目根目录创建.env文件,配置你的API密钥:
OPENAI_API_KEY=你的OpenAI API Key
OPENAI_BASE_URL=https://api.openai.com/v1 # 可替换为兼容的代理地址
一、基础单轮Tool Calling Agent(入门级智能体)
核心原理
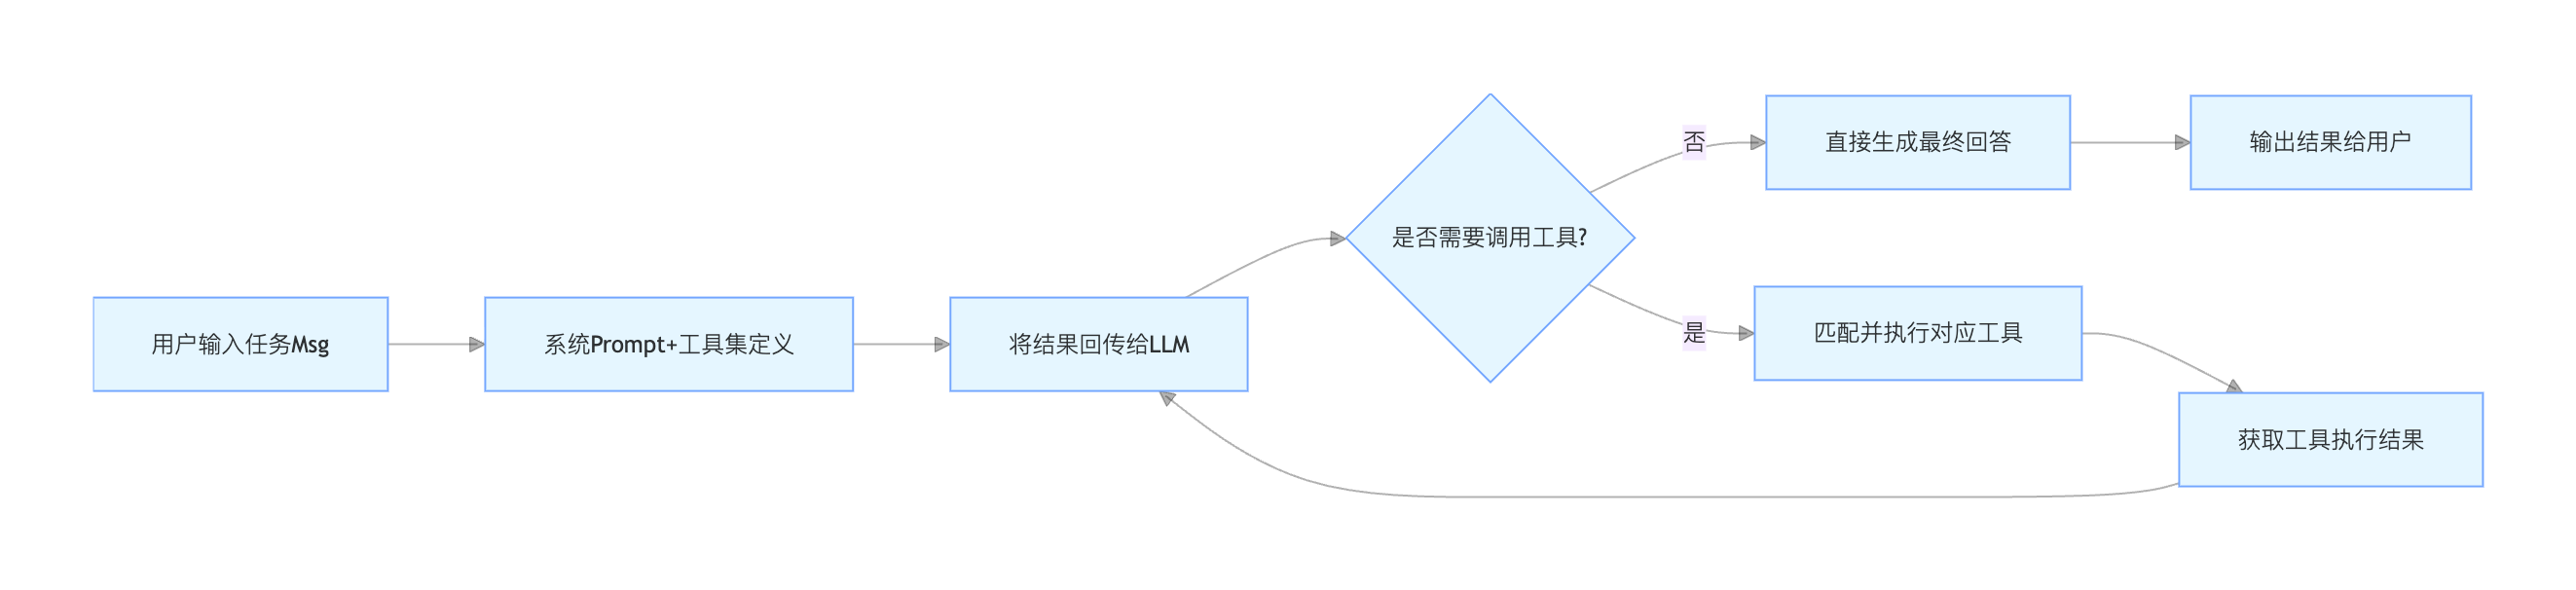
这是所有AI Agent的基础形态,也是最容易理解的架构。核心逻辑是:给LLM定义角色规则与可用工具集,用户输入任务后,LLM单次决策是否需要调用工具、调用哪个工具,最终整合工具结果生成回答。
整个流程只有单次决策循环,没有复杂的多轮推理,适合简单的工具调用场景,也是手写笔记中最顶层的基础Agent流程。
流程图(Mermaid)
完整JavaScript实现代码
require('dotenv').config();
const OpenAI = require('openai');

// 初始化OpenAI客户端
const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: process.env.OPENAI_BASE_URL,
});

// 1. 定义工具集:这里实现2个常用工具(计算器+天气查询)
const tools = [
  {
    type: "function",
    function: {
      name: "calculator",
      description: "通用计算器,支持加减乘除四则运算",
      parameters: {
        type: "object",
        properties: {
          expression: {
            type: "string",
            description: "要计算的数学表达式,例如:100*20+50",
          },
        },
        required: ["expression"],
      },
    },
  },
  {
    type: "function",
    function: {
      name: "get_weather",
      description: "查询指定城市的实时天气",
      parameters: {
        type: "object",
        properties: {
          city: {
            type: "string",
            description: "要查询的城市名称,例如:北京",
          },
        },
        required: ["city"],
      },
    },
  },
];

// 2. 实现工具的执行逻辑
async function executeTool(toolName, toolArgs) {
  switch (toolName) {
    case "calculator":
      try {
        // 安全执行表达式计算
        const result = eval(toolArgs.expression);
        return `计算结果:${toolArgs.expression} = ${result}`;
      } catch (e) {
        return `计算失败:表达式格式错误,${e.message}`;
      }
    case "get_weather":
      // 模拟天气接口,实际场景可替换为真实天气API
      const mockWeather = {
        "北京": "晴,10-18℃,北风3级",
        "上海": "小雨,15-22℃,东风2级",
        "深圳": "多云,20-28℃,南风1级",
      };
      const weather = mockWeather[toolArgs.city] || `暂无${toolArgs.city}的天气数据`;
      return `${toolArgs.city}实时天气:${weather}`;
    default:
      return `未知工具:${toolName},暂不支持该工具调用`;
  }
}

// 3. 基础单轮Agent主逻辑
async function baseAgent(userInput) {
  console.log(`用户输入:${userInput}\n`);

  // 第一轮调用LLM,判断是否需要调用工具
  const response = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: [
      {
        role: "system",
        content: "你是一个智能助手,你可以使用提供的工具完成用户的需求,优先使用工具解决问题,不要编造信息。",
      },
      { role: "user", content: userInput },
    ],
    tools: tools,
    tool_choice: "auto", // 让LLM自动决定是否调用工具
  });

  const responseMessage = response.choices[0].message;

  // 如果LLM决定调用工具
  if (responseMessage.tool_calls && responseMessage.tool_calls.length > 0) {
    const toolCalls = responseMessage.tool_calls;
    console.log(`LLM决定调用工具:${toolCalls.map(item => item.function.name).join(', ')}\n`);

    // 执行所有工具调用
    const toolResults = [];
    for (const toolCall of toolCalls) {
      const toolName = toolCall.function.name;
      const toolArgs = JSON.parse(toolCall.function.arguments);
      const result = await executeTool(toolName, toolArgs);
      toolResults.push({
        tool_call_id: toolCall.id,
        role: "tool",
        name: toolName,
        content: result,
      });
      console.log(`工具${toolName}执行结果:${result}\n`);
    }

    // 把工具结果回传给LLM,生成最终回答
    const finalResponse = await client.chat.completions.create({
      model: "gpt-3.5-turbo",
      messages: [
        {
          role: "system",
          content: "你是一个智能助手,根据工具执行结果,给用户清晰、准确的回答。",
        },
        { role: "user", content: userInput },
        responseMessage,
        ...toolResults,
      ],
    });

    return finalResponse.choices[0].message.content;
  }

  // 不需要调用工具,直接返回回答
  return responseMessage.content;
}

// 测试Agent
(async () => {
  // 测试1:需要调用工具的场景
  const result1 = await baseAgent("北京今天的天气是多少?帮我计算123*456+789的结果");
  console.log("最终回答:", result1);

  // 测试2:不需要调用工具的场景
  // const result2 = await baseAgent("介绍一下什么是AI Agent");
  // console.log("最终回答:", result2);
})();
优缺点&适用场景
| 维度 | 详情 |
|---|---|
| 优点 | 实现简单、延迟低、资源消耗少、逻辑清晰易维护 |
| 缺点 | 无法处理多步骤复杂任务、无自主推理能力、无法动态调整执行策略 |
| 适用场景 | 单轮工具调用、简单问答、客服机器人、固定流程的工具查询场景 |
二、ReAct 架构:推理-行动循环智能体
核心原理
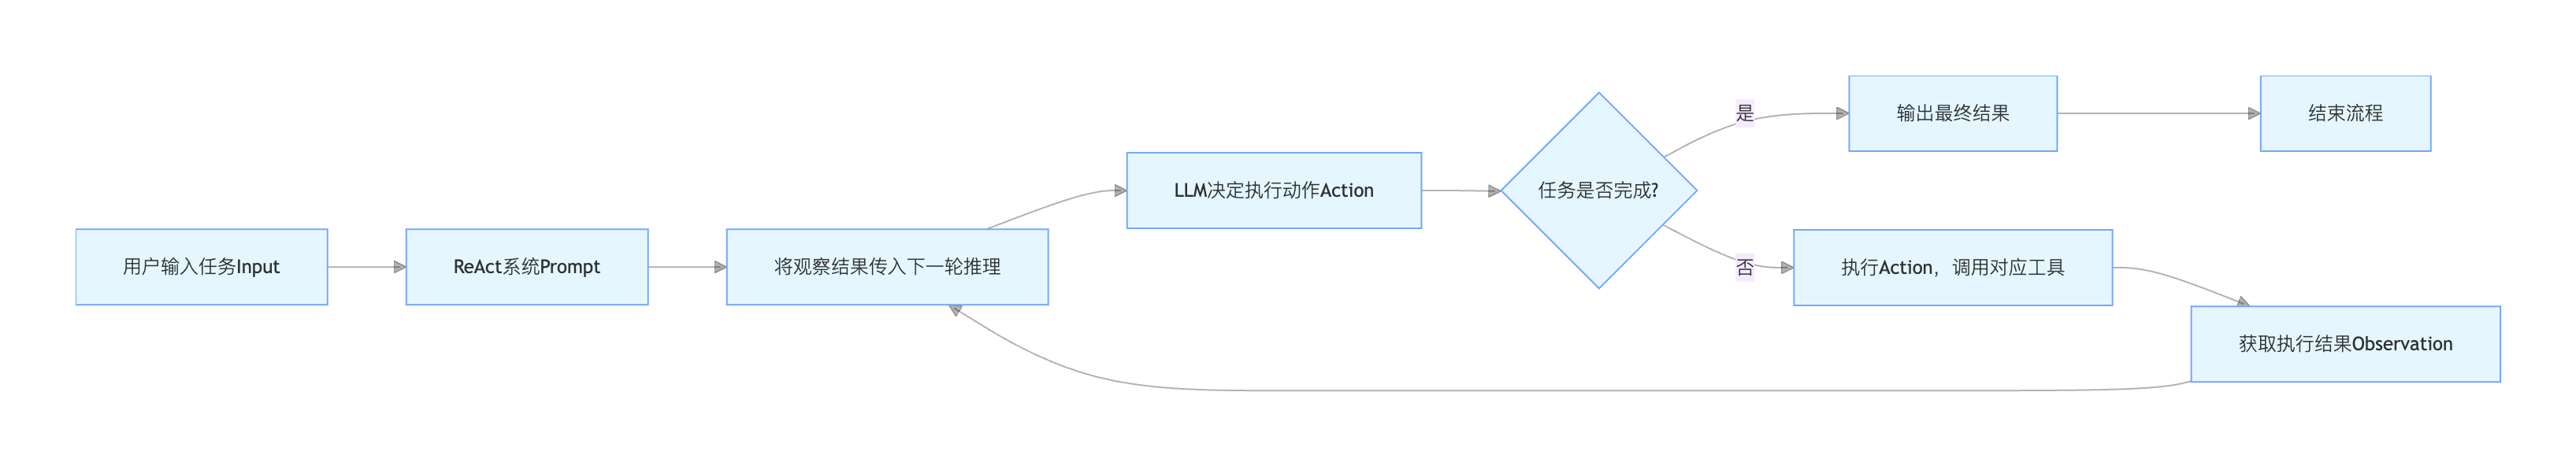
ReAct(Reasoning + Action)是AI Agent最经典的架构范式,也是手写笔记中重点标注的核心架构。它的核心设计是把“思考推理”和“行动执行”解耦,通过多轮循环完成任务。
每一轮循环都遵循固定的3步流程:
- Reasoning(推理):LLM基于当前任务和历史信息,思考“我现在要做什么、为什么要做、下一步该怎么行动”;
- Action(行动):基于推理结果,执行具体动作(调用工具、查询数据等);
- Observation(观察):获取行动的执行结果,作为下一轮推理的输入。
循环会持续执行,直到LLM判断任务已经完成,输出最终结果。这种边想边做的模式,让Agent具备了多步复杂任务的处理能力,可解释性极强。
流程图(Mermaid)
完整JavaScript实现代码
require('dotenv').config();
const OpenAI = require('openai');

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: process.env.OPENAI_BASE_URL,
});

// 工具集定义(扩展了搜索工具,适配多步任务)
const tools = [
  {
    type: "function",
    function: {
      name: "web_search",
      description: "网页搜索工具,查询互联网上的实时信息、最新数据",
      parameters: {
        type: "object",
        properties: {
          keyword: {
            type: "string",
            description: "搜索关键词",
          },
        },
        required: ["keyword"],
      },
    },
  },
  {
    type: "function",
    function: {
      name: "calculator",
      description: "通用计算器,支持加减乘除四则运算",
      parameters: {
        type: "object",
        properties: {
          expression: {
            type: "string",
            description: "要计算的数学表达式",
          },
        },
        required: ["expression"],
      },
    },
  },
];

// 工具执行逻辑
async function executeTool(toolName, toolArgs) {
  switch (toolName) {
    case "calculator":
      try {
        const result = eval(toolArgs.expression);
        return `计算结果:${toolArgs.expression} = ${result}`;
      } catch (e) {
        return `计算失败:${e.message}`;
      }
    case "web_search":
      // 模拟搜索接口,实际场景可替换为Serper/Google搜索API
      const mockSearchData = {
        "2026年北京4月平均气温": "2026年北京4月平均气温为8-20℃,平均降水天数为5天",
        "2026年北京4月天气趋势": "2026年北京4月上旬以晴天为主,中旬有2次小雨,下旬气温回升至25℃左右",
        "北京4月穿衣指南": "北京4月建议穿薄外套+长袖内搭,早晚温差大,可备一件薄毛衣",
      };
      const result = mockSearchData[toolArgs.keyword] || `未搜索到【${toolArgs.keyword}】的相关信息`;
      return `搜索结果:${result}`;
    default:
      return `未知工具:${toolName}`;
  }
}

// ReAct Agent 主逻辑
async function reactAgent(userInput, maxLoop = 5) {
  console.log(`用户任务:${userInput}\n`);
  // 历史消息数组,保存完整的推理-行动-观察流程
  const messages = [
    {
      role: "system",
      content: `
你是一个ReAct架构的AI智能体,严格按照以下流程完成用户任务:
1. 思考(Thought):先分析用户的需求,明确你需要做什么,下一步要执行什么动作,必须清晰说明你的推理过程
2. 行动(Action):基于思考结果,决定调用哪个工具,必须严格按照工具定义的格式调用
3. 观察(Observation):获取工具执行的结果,基于结果进行下一轮思考

循环执行以上3步,直到你确认任务已经完成,再输出最终答案。
注意:
- 每次只执行一个动作,不要一次调用多个工具
- 不要编造信息,所有数据必须来自工具执行结果
- 当你获取了足够的信息,直接输出最终答案,不要多余循环
- 输出格式:
  Thought: 你的推理思考内容
  Action: 要调用的工具名称和参数
      `,
    },
    { role: "user", content: userInput },
  ];

  // 循环执行ReAct流程,限制最大循环次数防止死循环
  for (let i = 0; i < maxLoop; i++) {
    console.log(`========== 第${i+1}轮ReAct循环 ==========`);
    // 调用LLM生成思考和行动
    const response = await client.chat.completions.create({
      model: "gpt-3.5-turbo",
      messages: messages,
      tools: tools,
      tool_choice: "auto",
    });

    const responseMessage = response.choices[0].message;
    console.log(`LLM输出:\n${responseMessage.content}\n`);

    // 如果LLM没有调用工具,说明任务完成,直接返回结果
    if (!responseMessage.tool_calls || responseMessage.tool_calls.length === 0) {
      console.log("任务完成,结束循环");
      return responseMessage.content;
    }

    // 执行工具调用
    const toolCall = responseMessage.tool_calls[0];
    const toolName = toolCall.function.name;
    const toolArgs = JSON.parse(toolCall.function.arguments);
    console.log(`执行工具调用:${toolName},参数:${JSON.stringify(toolArgs)}`);

    const toolResult = await executeTool(toolName, toolArgs);
    console.log(`观察结果:${toolResult}\n`);

    // 把本轮的思考、行动、观察结果加入历史消息,进入下一轮循环
    messages.push(responseMessage);
    messages.push({
      tool_call_id: toolCall.id,
      role: "tool",
      name: toolName,
      content: toolResult,
    });
  }

  // 达到最大循环次数,返回最终结果
  const finalResponse = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: [
      ...messages,
      { role: "user", content: "你已经达到最大循环次数,请基于已有信息输出最终答案" },
    ],
  });
  return finalResponse.choices[0].message.content;
}

// 测试ReAct Agent
(async () => {
  const result = await reactAgent("2026年北京4月的天气怎么样?我要去北京出差7天,帮我制定一份穿衣指南");
  console.log("\n最终回答:\n", result);
})();
优缺点&适用场景
| 维度 | 详情 |
|---|---|
| 优点 | 具备多步复杂任务处理能力、推理过程可解释、可动态调整执行策略、容错率高 |
| 缺点 | 循环次数过多会导致延迟升高、长任务容易出现上下文偏移、不适合超大型任务的宏观规划 |
| 适用场景 | 信息检索、多步工具调用、数据分析、问题排查、自动化脚本执行等需要边推理边执行的场景 |
三、Plan & Execute 架构:规划-执行分步智能体
核心原理
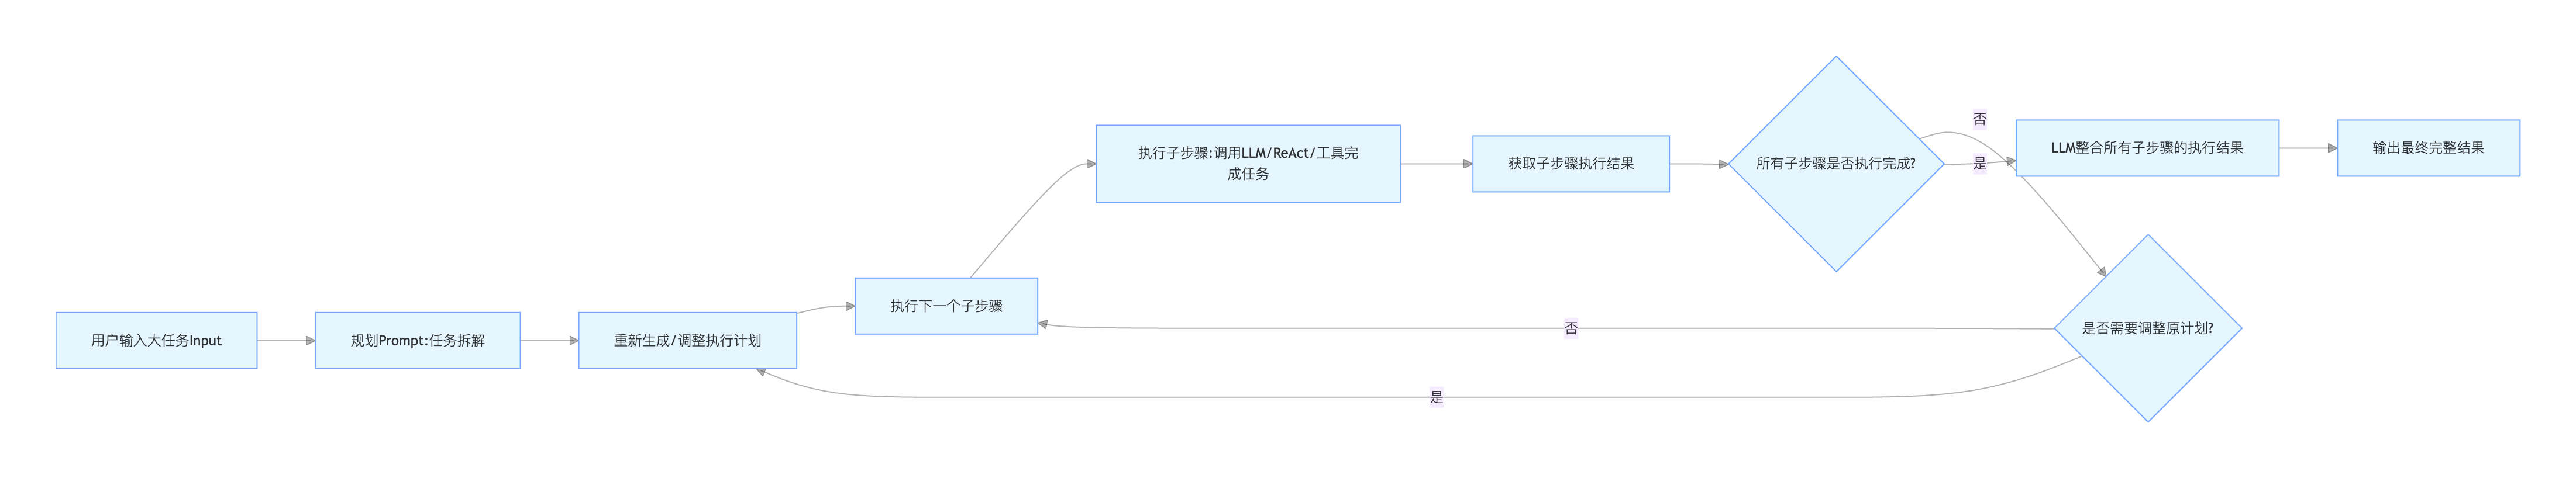
Plan & Execute(规划-执行)架构的核心设计是先规划、后执行,区别于ReAct的“边想边做”,它会先把用户的大任务拆解成结构化、可执行的子步骤,生成完整的执行计划,再逐个执行子步骤,执行过程中可根据结果动态调整计划。
这种架构把“规划能力”和“执行能力”解耦,适合长流程、多节点的复杂任务,也是手写笔记中重点标注的第二种核心架构。
流程图(Mermaid)
完整JavaScript实现代码
require('dotenv').config();
const OpenAI = require('openai');

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: process.env.OPENAI_BASE_URL,
});

// 1. 规划器:负责拆解任务,生成执行计划
async function planGenerator(userInput) {
  const response = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: [
      {
        role: "system",
        content: `
你是一个专业的任务规划师,用户会给你一个复杂的大任务,你需要把它拆解成3-6个可执行、顺序执行的子步骤,生成结构化的执行计划。
要求:
1. 每个子步骤必须清晰、具体,可独立执行
2. 步骤之间有明确的先后顺序,前一个步骤的结果会作为后一个步骤的输入
3. 输出格式严格为JSON数组,每个元素包含stepNumber(步骤序号)、stepName(步骤名称)、stepDesc(步骤详细描述),不要输出其他内容
示例:
[{"stepNumber":1,"stepName":"确定博客大纲","stepDesc":"根据用户需求,确定AI Agent博客的章节结构和核心内容"},{"stepNumber":2,"stepName":"收集核心资料","stepDesc":"搜索AI Agent架构的相关资料,整理核心原理和案例"}]
        `,
      },
      { role: "user", content: userInput },
    ],
  });

  try {
    return JSON.parse(response.choices[0].message.content);
  } catch (e) {
    throw new Error(`计划生成失败:${e.message},LLM输出:${response.choices[0].message.content}`);
  }
}

// 2. 执行器:负责执行单个子步骤
async function stepExecutor(step, historyResults) {
  const response = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: [
      {
        role: "system",
        content: `
你是一个专业的任务执行器,负责执行计划中的单个子步骤,结合之前步骤的执行结果,完成当前步骤的任务。
要求:
1. 严格按照步骤描述执行任务,不要偏离需求
2. 输出内容要完整、详细,符合步骤要求
3. 不要输出无关内容,只输出当前步骤的执行结果
        `,
      },
      {
        role: "user",
        content: `
之前步骤的执行结果:
${JSON.stringify(historyResults, null, 2)}

当前需要执行的步骤:
步骤序号:${step.stepNumber}
步骤名称:${step.stepName}
步骤描述:${step.stepDesc}

请完成当前步骤的执行,输出执行结果。
        `,
      },
    ],
  });

  return {
    stepNumber: step.stepNumber,
    stepName: step.stepName,
    result: response.choices[0].message.content,
  };
}

// 3. 整合器:负责整合所有步骤的结果,生成最终输出
async function resultIntegrator(userInput, allStepResults) {
  const response = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: [
      {
        role: "system",
        content: `
你是一个内容整合专家,用户的原始任务和所有子步骤的执行结果已经给出,你需要把这些结果整合起来,生成一份完整、流畅、逻辑清晰的最终结果。
要求:
1. 严格贴合用户的原始需求,不要偏离主题
2. 保留所有核心信息,结构清晰,可读性强
3. 不要遗漏任何步骤的关键内容
        `,
      },
      {
        role: "user",
        content: `
用户原始任务:${userInput}

所有子步骤的执行结果:
${JSON.stringify(allStepResults, null, 2)}

请整合以上内容,生成最终的完整结果。
        `,
      },
    ],
  });

  return response.choices[0].message.content;
}

// 4. Plan & Execute Agent 主逻辑
async function planExecuteAgent(userInput) {
  console.log(`用户任务:${userInput}\n`);

  // 第一步:生成执行计划
  console.log("========== 1. 生成执行计划 ==========");
  const plan = await planGenerator(userInput);
  console.log(`生成的执行计划:\n${JSON.stringify(plan, null, 2)}\n`);

  // 第二步:循环执行每个子步骤
  console.log("========== 2. 执行计划步骤 ==========");
  const stepResults = [];
  for (const step of plan) {
    console.log(`正在执行步骤${step.stepNumber}:${step.stepName}`);
    const stepResult = await stepExecutor(step, stepResults);
    stepResults.push(stepResult);
    console.log(`步骤${step.stepNumber}执行完成,结果:\n${stepResult.result}\n`);
  }

  // 第三步:整合所有结果,生成最终输出
  console.log("========== 3. 整合最终结果 ==========");
  const finalResult = await resultIntegrator(userInput, stepResults);

  return finalResult;
}

// 测试Plan & Execute Agent
(async () => {
  const result = await planExecuteAgent("写一篇关于AI Agent Plan & Execute架构的技术博客,包含原理、流程图、代码示例、适用场景");
  console.log("\n最终博客内容:\n", result);
})();
优缺点&适用场景
| 维度 | 详情 |
|---|---|
| 优点 | 适合超大型长流程任务、任务拆解清晰可控、可并行执行子步骤、宏观规划能力强、可对接ReAct作为执行器 |
| 缺点 | 初始计划不合理会导致执行偏差、动态调整能力弱于ReAct、实现复杂度更高 |
| 适用场景 | 长文案创作、项目开发、数据分析报告、多步骤自动化流程、大型内容生成等需要先规划后执行的场景 |
四、Reflection 自省架构:迭代优化智能体
核心原理
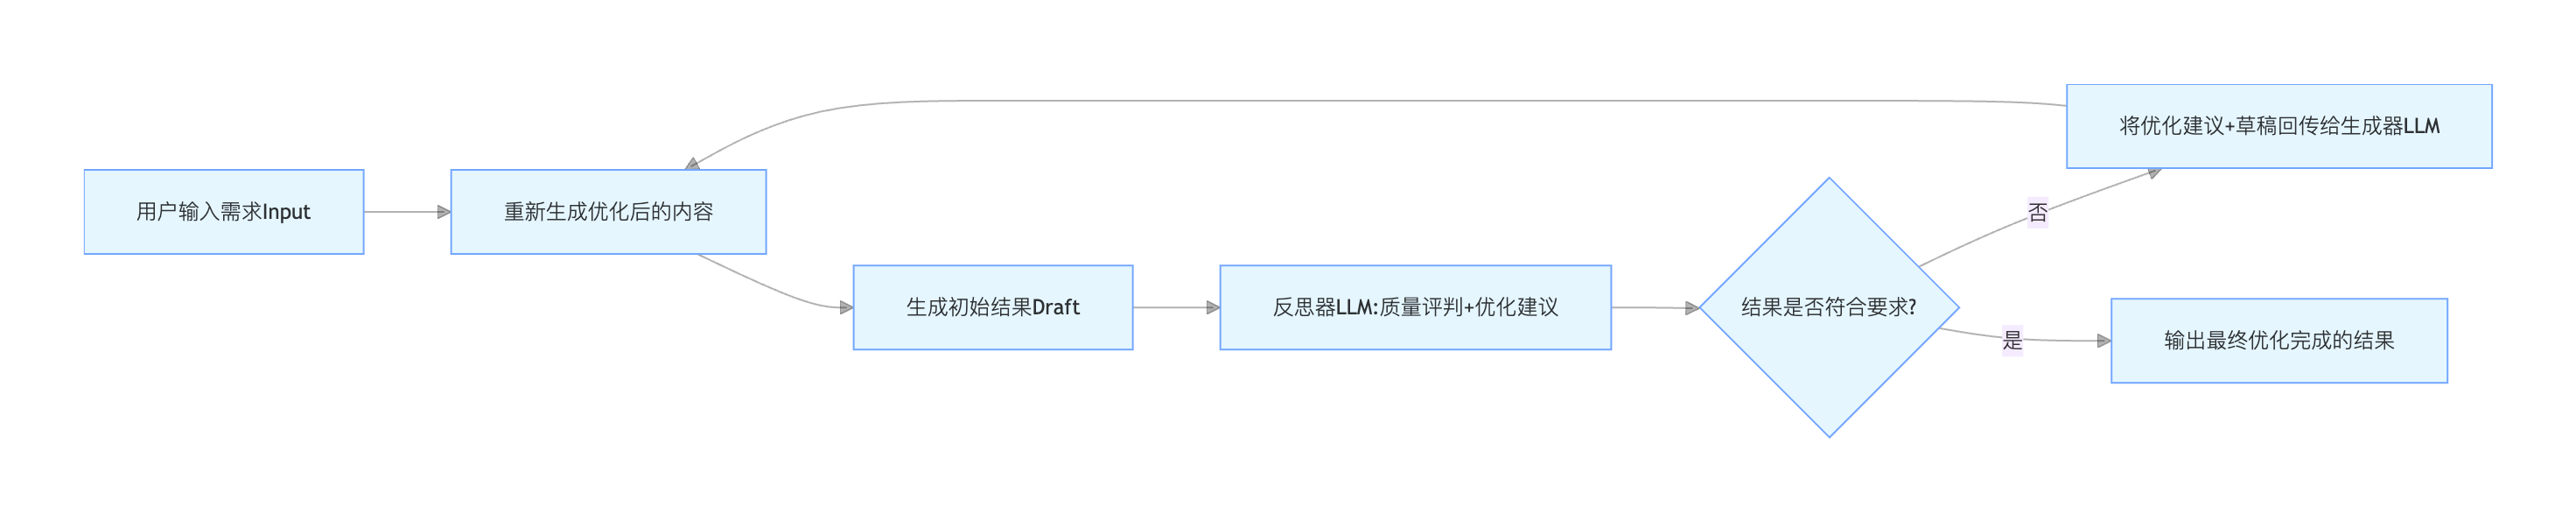
Reflection(自省/反思)架构的核心是引入“自我评判+迭代优化”的闭环,通过双LLM分工(生成器+反思器),让Agent具备自我纠错、自我优化的能力。
核心流程分为3个环节:
- 生成环节:生成器LLM基于用户需求,生成初始内容/结果;
- 反思环节:反思器LLM基于用户需求,评判生成结果的质量,指出问题、给出具体的优化建议;
- 迭代环节:把反思结果和初始内容回传给生成器,重新优化生成,直到结果符合要求。
这种架构极大提升了输出内容的质量,适合对结果精度、完整性、规范性有高要求的场景,也是手写笔记中重点标注的第三种核心架构。
流程图(Mermaid)
完整JavaScript实现代码
require('dotenv').config();
const OpenAI = require('openai');

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: process.env.OPENAI_BASE_URL,
});

// 1. 生成器:负责生成初始内容和迭代优化
async function generatorLLM(userInput, historyDraft = "", reflectionAdvice = "") {
  const messages = [
    {
      role: "system",
      content: `
你是一个专业的内容生成专家,根据用户的需求生成高质量的内容。
如果有历史草稿和反思优化建议,你需要严格按照优化建议,对历史草稿进行修改和优化,生成更符合要求的内容。
要求:
1. 内容完整、逻辑清晰、专业严谨
2. 严格贴合用户的需求,不要偏离主题
3. 针对优化建议,必须逐条修改,不要遗漏问题
      `,
    },
    { role: "user", content: userInput },
  ];

  // 如果有历史草稿和反思建议,加入上下文
  if (historyDraft && reflectionAdvice) {
    messages.push({
      role: "user",
      content: `
历史草稿:
${historyDraft}

反思优化建议:
${reflectionAdvice}

请根据优化建议,对历史草稿进行全面优化,生成新的内容。
      `,
    });
  }

  const response = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: messages,
  });

  return response.choices[0].message.content;
}

// 2. 反思器:负责评判内容质量,给出优化建议
async function reflectorLLM(userInput, draftContent) {
  const response = await client.chat.completions.create({
    model: "gpt-3.5-turbo",
    messages: [
      {
        role: "system",
        content: `
你是一个专业的内容质量评判专家,用户的原始需求和生成的草稿内容已经给出,你需要:
1. 从完整性、准确性、逻辑性、专业性、可读性5个维度,评判草稿内容是否符合用户需求
2. 指出草稿中存在的所有问题,越具体越好
3. 给出逐条对应的优化建议,可落地、可执行
4. 最后给出评判结果:通过/不通过。只有当内容完全符合用户需求,没有明显问题时,才能给出“通过”的结果
要求:输出结构清晰,先给出整体评判,再列出问题和优化建议,最后给出评判结果。
        `,
      },
      {
        role: "user",
        content: `
用户原始需求:${userInput}

生成的草稿内容:
${draftContent}

请按照要求完成质量评判和优化建议输出。
        `,
      },
    ],
  });

  const reflectionResult = response.choices[0].message.content;
  // 提取是否通过的结果
  const isPass = reflectionResult.includes("评判结果:通过") || reflectionResult.includes("最终结果:通过");
  return {
    isPass,
    advice: reflectionResult,
  };
}

// 3. Reflection Agent 主逻辑
async function reflectionAgent(userInput, maxIteration = 3) {
  console.log(`用户需求:${userInput}\n`);
  let currentDraft = "";
  let iterationCount = 0;

  // 第一轮生成初始草稿
  console.log("========== 第1轮:生成初始草稿 ==========");
  currentDraft = await generatorLLM(userInput);
  console.log(`初始草稿生成完成:\n${currentDraft}\n`);

  // 循环反思迭代
  while (iterationCount < maxIteration) {
    iterationCount++;
    console.log(`========== 第${iterationCount}轮:反思评判 ==========`);

    // 反思器评判
    const reflectionResult = await reflectorLLM(userInput, currentDraft);
    console.log(`反思结果:\n${reflectionResult.advice}\n`);

    // 如果通过,直接返回结果
    if (reflectionResult.isPass) {
      console.log("内容通过评判,结束迭代");
      return currentDraft;
    }

    // 未通过,且未达到最大迭代次数,重新生成
    if (iterationCount < maxIteration) {
      console.log(`========== 第${iterationCount+1}轮:迭代优化 ==========`);
      currentDraft = await generatorLLM(userInput, currentDraft, reflectionResult.advice);
      console.log(`优化后的内容:\n${currentDraft}\n`);
    }
  }

  // 达到最大迭代次数,返回最终内容
  console.log("达到最大迭代次数,返回最终内容");
  return currentDraft;
}

// 测试Reflection Agent
(async () => {
  const result = await reflectionAgent("用JavaScript写一个快速排序算法,要求代码规范、有详细注释、有测试用例、有算法复杂度分析");
  console.log("\n最终优化完成的内容:\n", result);
})();
优缺点&适用场景
| 维度 | 详情 |
|---|---|
| 优点 | 输出内容质量极高、具备自我纠错能力、可定制评判标准、适配高要求的生成场景 |
| 缺点 | Token消耗大、延迟高、迭代次数不可控、对LLM的评判能力要求高 |
| 适用场景 | 代码生成、文案创作、方案设计、报告撰写、学术内容生成等对质量有高要求的场景 |
五、工业级融合架构:Plan + ReAct + Reflection 全链路智能体
核心原理
在实际的工业级落地场景中,很少单独使用某一种架构,而是把以上3种架构融合起来,形成**“先规划 → 再用ReAct执行每个步骤 → 最后用Reflection反思优化”**的全链路架构,这也是手写笔记最右侧标注的完整Agent流程。
这种融合架构兼顾了宏观规划能力、多步执行能力和质量优化能力,是目前AutoGPT、LangGraph、CrewAI等主流Agent框架的核心设计思路。
流程图(Mermaid)
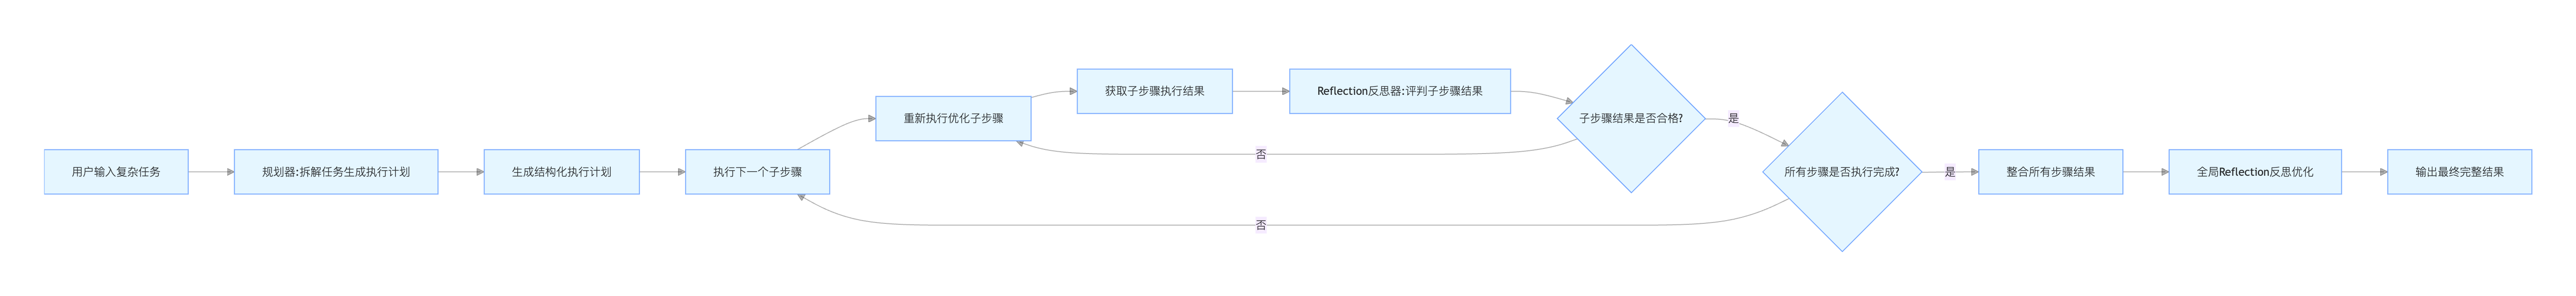
实现思路
基于前文的3个基础架构,你可以快速搭建融合架构:
- 复用
planGenerator作为全局规划器,拆解大任务; - 每个子步骤调用
reactAgent作为执行器,完成多步工具调用和推理; - 每个子步骤执行完成后,调用
reflectorLLM做单步质量校验,不合格则重新执行; - 所有步骤执行完成后,做全局内容整合和最终的Reflection优化,输出结果。
六、总结与架构选型建议
核心架构对比总表
| 架构模式 | 核心能力 | 实现难度 | 延迟 | 资源消耗 | 核心优势 |
|---|---|---|---|---|---|
| 基础Tool Calling | 单轮工具调用 | 极低 | 低 | 极低 | 简单易用,适合入门 |
| ReAct | 多步推理执行 | 中等 | 中等 | 中等 | 可解释性强,适配通用复杂任务 |
| Plan & Execute | 长任务规划执行 | 较高 | 高 | 较高 | 宏观规划能力强,适配超大型任务 |
| Reflection | 自我优化迭代 | 较高 | 高 | 高 | 输出质量高,适配高标准生成场景 |
选型建议
- 简单工具查询、客服场景:优先选择基础Tool Calling Agent,轻量高效;
- 信息检索、多步工具调用、问题排查:优先选择ReAct架构,边想边做,灵活可控;
- 长文案创作、项目开发、大型报告生成:优先选择Plan & Execute架构,先规划后执行,结构清晰;
- 代码生成、方案设计、高质量内容创作:优先选择Reflection架构,迭代优化,保障输出质量;
- 工业级复杂场景(自动化办公、全流程AI助手):选择Plan + ReAct + Reflection融合架构,兼顾所有能力。