RAG:从原理到落地(含实操细节)
一、RAG 基本介绍:为什么前端也需要懂 RAG?
在前端 AI 应用开发中,我们经常会遇到一个核心痛点:通用大模型(如 GPT、豆包、通义千问)无法知晓我们的业务专属知识(比如公司产品细节、内部文档、行业专属数据),要么回答“不知道”,要么胡编乱造(即“大模型幻觉”),这显然无法满足业务需求。
而 RAG(Retrieval-Augmented Generation,中文:检索增强生成),正是为解决这个问题而生的技术——它的核心思想非常简单:为大模型“外挂一个临时知识库”,在生成回答前,先从这个专属知识库中检索出与用户问题相关的内容,再将这些内容作为上下文传递给大模型,让大模型基于“通用知识+专属知识”生成准确、可靠的回答。
1. 核心价值:解决大模型的两大痛点
-
痛点1:知识库无法快速更新:大模型的训练数据有时间局限性(比如训练截止到2023年),无法实时获取最新的业务数据、产品信息,而 RAG 可以随时更新外挂知识库,无需重新训练大模型(重新训练大模型不仅耗时久,成本也极高)。
-
痛点2:大模型幻觉:当大模型遇到不熟悉的内容时,会“一本正经地胡说八道”,而 RAG 通过检索真实的专属知识库,能有效约束大模型的回答,避免幻觉,提升回答的准确性。
2. 前端视角的实操案例:产品咨询工具
假设我们需要给公司官网开发一个“香蕉手机”自助咨询工具,允许用户用自然语言提问产品相关问题(比如“香蕉手机和XX手机的区别”“香蕉手机的售后政策是什么”),并嵌入到前端页面中。
如果直接调用通用大模型,会出现两种糟糕情况:
-
大模型回答:“我不知道什么是香蕉手机”(因为香蕉手机是公司专属产品,不在通用大模型的训练数据中);
-
大模型胡编乱造:“香蕉手机是XX公司推出的一款折叠屏手机,支持5G网络...”(完全不符合实际产品信息,即幻觉)。
3. RAG 出现前的低效解决方案(前端避坑)
在 RAG 普及前,前端开发者可能会尝试将产品资料直接拼接成 Prompt 传给大模型,比如:
【系统提示】你是香蕉手机的客服助手,以下是香蕉手机的产品资料:
1. 香蕉手机是XX公司2025年推出的旗舰机,搭载骁龙8 Gen3处理器,屏幕为6.7英寸OLED直屏,支持120Hz高刷;
2. 香蕉手机内置5000mAh电池,支持65W有线快充,不支持无线充电;
3. 香蕉手机的售后政策:7天无理由退货,1年质保,质量问题可免费维修。
【用户问题】香蕉手机支持无线充电吗?
这种方式看似可行,但存在致命问题:
如果产品资料非常多(比如几十页文档、几十万字),将所有内容拼接成 Prompt 传给大模型,会超出大模型的上下文窗口限制(比如 OpenAI 的 GPT-3.5 上下文窗口仅4096词元),即使没超出,大模型也无法快速定位到与用户问题相关的内容,导致回答不准确、效率低。
而 RAG 正是解决这个问题的最优方案——它将庞大的知识库拆解、索引,在用户提问时,只检索出最相关的内容传给大模型,既节省上下文空间,又提升回答准确性。
二、RAG 经典架构:前端需掌握的两大核心阶段
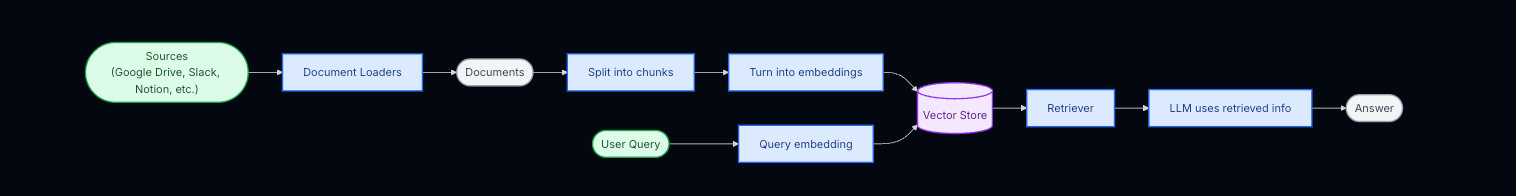
RAG 应用的核心流程分为两个阶段:数据索引(Data Indexing) 和数据查询(Query)。前端开发者不需要深入实现底层逻辑,但必须理解每个阶段的作用、关键步骤,才能更好地对接后端接口、处理前端交互(比如文档上传、查询加载、结果渲染)。
整体架构流程图如下(前端视角重点关注红色标注部分):
阶段1:数据索引(离线准备阶段)
数据索引是 RAG 的“准备工作”,核心是将我们的专属知识库(如产品文档、PDF、Markdown)处理成可被快速检索的格式,存入向量数据库。这个阶段通常由后端完成,但前端需要了解其流程,才能更好地开发“文档上传”等交互功能(比如前端上传 PDF 文档,后端进行后续处理)。
数据索引分为4个关键步骤,每个步骤都有明确的逻辑和实操细节:
步骤1:加载文档(Document Loading)
首先需要将我们的专属知识库文档加载到系统中,常见的文档格式包括 PDF、Markdown、Word、TXT 等。对于前端来说,我们需要做的是开发“文档上传”组件,将用户上传的文档(比如产品手册 PDF)通过接口传给后端,后端再通过工具(如 PyPDF2、LangChain 的 DocumentLoader)解析文档内容。
示例(前端 Vue 3 文档上传组件片段):
<template>
  <input
    type="file"
    accept=".pdf,.md,.txt"
    @change="handleFileUpload"
    class="file-upload"
  />
</template>

<script setup>
import { ref } from 'vue';
import axios from 'axios';

const handleFileUpload = async (e) => {
  const file = e.target.files[0];
  if (!file) return;

  const formData = new FormData();
  formData.append('document', file);

  // 传给后端,进行文档加载和后续处理
  await axios.post('/api/rag/index/document', formData, {
    headers: { 'Content-Type': 'multipart/form-data' }
  });
};
</script>
步骤2:切分成 Chunks(文档分割)
加载文档后,需要将文档切分成一个个小的“知识块”(Chunk),这是 RAG 中非常关键的一步——如果分割太粗,会导致检索不准确;如果分割太细,会丢失语义完整性(比如一句话被拆成两段,导致大模型无法理解完整含义)。
分割的核心原则是 “语义完整 + 适配模型词元限制”,常见的分割策略有两种,可组合使用:
策略1:语义结构维度(优先保证语义完整)
按照文档的语义结构分割,比如以句号、问号、叹号等标点符号为分隔符,将每一个完整的句子或段落作为一个 Chunk。这种方式能避免“断句”,保证每个 Chunk 的语义完整。
示例:
原文(香蕉手机产品介绍):
香蕉手机是XX公司2025年推出的旗舰机,搭载骁龙8 Gen3处理器,屏幕为6.7英寸OLED直屏,支持120Hz高刷。它内置5000mAh电池,支持65W有线快充,不支持无线充电。售后政策为7天无理由退货,1年质保。
分割后(3个 Chunk):
Chunk1:香蕉手机是XX公司2025年推出的旗舰机,搭载骁龙8 Gen3处理器,屏幕为6.7英寸OLED直屏,支持120Hz高刷。
Chunk2:它内置5000mAh电池,支持65W有线快充,不支持无线充电。
Chunk3:售后政策为7天无理由退货,1年质保。
策略2:实现策略维度(适配模型词元限制)
通用大模型的 Embedding 接口(用于将文本转为向量)有词元限制(比如 OpenAI 的 text-embedding-ada-002 最大支持8192词元),如果 Chunk 太长,会超出限制,无法转为向量。因此需要结合词元限制进行分割:
-
固定长度字符切分:每 N 个字符为一段(比如每500个字符一段),适合规则性较强的文档(如 TXT 文档);
-
词元切分:每 N 个词元为一段(比如每200个词元一段),兼容模型的词元限制,更精准。
前端视角:我们不需要实现分割逻辑,但需要知道后端的分割规则,比如在文档上传后,提示用户“文档正在分割处理”,并展示处理进度(提升用户体验)。
步骤3:转化为向量嵌入(Embedding)
计算机无法直接理解文本的语义,因此需要将每个 Chunk 转化为“高维向量”(Embedding)——这个向量是一个由浮点数组成的数组,每个数值代表文本的一个语义特征,向量之间的相似度越高,代表文本的语义越接近。
常见的 Embedding 模型有:OpenAI 的 text-embedding-ada-002、字节跳动的 embedding 模型、阿里通义千问的 embedding 模型等。不同模型生成的向量长度不同,比如 text-embedding-ada-002 生成的向量长度为1536,部分模型为768。
示例(一个 Chunk 的向量表示):
[0.112, -0.045, 0.203, 0.098, -0.121, ..., 0.087] // 共1536个浮点数,省略中间部分
前端视角:这个步骤完全由后端完成,我们只需要知道——后端会将分割后的 Chunk 转为向量,为后续检索做准备。
步骤4:存入向量数据库
将转化后的向量(以及对应的 Chunk 文本)存入“向量数据库”——向量数据库与传统数据库(如 MySQL)的核心区别是:它支持“语义相似度检索”,能快速找到与用户问题向量最相似的 Chunk 向量。
对于前端开发者来说,不需要深入了解向量数据库的底层实现,但需要知道常见的向量数据库及其特点,以便在对接后端时,了解数据存储逻辑:
| 向量数据库 | 特点 | 前端适配建议 |
|---|---|---|
| Supabase | PostgreSQL + pgvector 扩展,支持关系型数据+向量数据,易部署 | 适合中小型项目,前端可通过 Supabase SDK 间接对接 |
| Weaviate | 云服务+本地部署均可,支持多模态检索(文本、图片) | 适合需要多模态功能的 AI 应用(如图片+文本问答) |
| Pinecone | 高性能、易接入,全托管服务,无需自己部署 | 适合快速落地,前端只需调用后端接口,无需关注部署 |
| Milvus | 支持海量数据、高性能搜索,适合大型项目 | 适合业务规模较大、知识库数据较多的场景 |
| MemoryVectorStore | 纯 JS 内存向量库,无需部署,轻量 | 适合前端本地测试、小型 Demo 开发(生产环境不推荐) |
阶段2:数据查询(在线交互阶段)
数据查询是 RAG 的“核心交互阶段”,也是前端开发者最需要关注的部分——用户在前端输入问题(Query),前端将问题传给后端,后端完成“检索+生成”,最后前端渲染回答结果。
这个阶段分为两大核心步骤:检索(Retrieval)和生成(Generation),流程如下:
步骤1:检索(Retrieval)—— 找到最相关的知识
检索的核心是“语义相似度匹配”,即根据用户的问题,从向量数据库中找到与问题最相关的 Chunk。具体步骤如下:
-
前端将用户输入的问题(Query)通过接口传给后端;
-
后端将 Query 转化为向量(使用与 Chunk 相同的 Embedding 模型);
-
后端在向量数据库中进行“相似度检索”,常用的相似度计算方式有3种:
-
余弦相似度:最常用,取值范围[-1,1],越接近1,语义越相似;
-
欧氏距离:取值范围[0,∞),距离越小,语义越相似;
-
点积:取值范围[-∞,∞),值越大,语义越相似。
-
-
后端返回Top N个最相似的 Chunk(比如Top3),作为“相关知识”,传给生成阶段。
前端视角:我们需要开发“问题输入”组件,处理加载状态(比如检索时显示“正在检索相关内容...”),并接收后端返回的相关 Chunk(可选:在回答下方展示“参考资料”,提升用户信任度)。
示例(前端 Vue 3 问题提交片段):
<template>
  <div class="query-container">
    <input
      v-model="query"
      placeholder="请输入你的问题..."
      @keyup.enter="handleQuery"
    />
    <button @click="handleQuery" :disabled="loading">
      {{ loading ? '正在检索...' : '提问' }}
    </button>
    <div class="reference" v-if="references.length">
      <h4>参考资料:</h4>
      <ul>
        <li v-for="(ref, index) in references" :key="index">{{ ref }}</li>
      </ul>
    </div>
  </div>
</template>

<script setup>
import { ref } from 'vue';
import axios from 'axios';

const query = ref('');
const loading = ref(false);
const references = ref([]); // 存储检索到的相关 Chunk

const handleQuery = async () => {
  if (!query.value.trim()) return;
  loading.value = true;
  try {
    const res = await axios.post('/api/rag/query', { query: query.value });
    // 渲染回答(省略)
    references.value = res.data.references; // 接收检索到的相关 Chunk
  } catch (err) {
    console.error('查询失败:', err);
  } finally {
    loading.value = false;
  }
};
</script>
步骤2:生成(Generation)—— 让大模型生成准确回答
生成阶段的核心是“构造 Prompt + 调用大模型”,后端会将“检索到的相关 Chunk + 用户问题”拼接成一个完整的 Prompt,传给大模型,让大模型基于这些内容生成回答,避免幻觉。
Prompt 的构造有固定的模板,前端开发者可以了解其结构,以便在需要自定义 Prompt 时(比如修改客服语气),对接后端进行调整。
Prompt 构造模板(以香蕉手机咨询为例):
【系统提示】
你是香蕉手机的智能客服助手,严格基于以下提供的资料回答用户问题,不要添加任何资料中没有的内容,不要胡编乱造。如果资料中没有相关答案,直接回答“抱歉,暂时无法解答你的问题,请联系人工客服。”

【参考资料】(检索到的相关 Chunk)
1. 香蕉手机内置5000mAh电池,支持65W有线快充,不支持无线充电。
2. 香蕉手机的售后政策为7天无理由退货,1年质保。

【用户问题】
香蕉手机支持无线充电吗?

【你的回答】
大模型基于这个 Prompt,会生成准确的回答:“香蕉手机不支持无线充电,它内置5000mAh电池,支持65W有线快充。”
前端视角:我们需要处理大模型的生成结果,比如支持流式输出(打字机效果,提升用户体验)、渲染富文本(比如加粗、换行)、处理错误状态(比如大模型调用失败)。
示例(前端流式输出效果片段,基于 WebSocket):
<template>
  <div class="answer-container">
    <div class="answer" v-html="answer"></div>
  </div>
</template>

<script setup>
import { ref, onUnmounted } from 'vue';

const query = ref('');
const answer = ref('');
let socket = null;

const handleStreamQuery = () => {
  // 建立 WebSocket 连接,接收流式输出
  socket = new WebSocket(`ws://your-server.com/api/rag/stream?query=${encodeURIComponent(query.value)}`);

  socket.onmessage = (e) => {
    // 拼接流式返回的内容,实现打字机效果
    answer.value += e.data;
  };

  socket.onclose = () => {
    console.log('流式连接关闭');
  };
};

onUnmounted(() => {
  if (socket) socket.close();
});
</script>
三、前端视角总结:RAG 核心要点与落地建议
作为前端,我们不需要实现 RAG 的底层逻辑(如向量转化、相似度检索),但需要掌握以下核心要点,才能更好地对接后端、开发前端 AI 应用:
-
理解 RAG 的核心价值:记住 RAG 是“给大模型外挂知识库”,解决幻觉和知识库更新问题,是前端 AI 应用落地的关键;
-
掌握两大核心阶段:数据索引(离线准备)和数据查询(在线交互),知道每个阶段的关键步骤,才能对接后端接口;
-
聚焦前端交互开发:重点开发文档上传、问题输入、加载状态、流式输出、结果渲染、参考资料展示等功能,提升用户体验;
-
熟悉常见向量数据库:了解不同向量数据库的特点,根据项目规模选择合适的方案(比如小型 Demo 用 MemoryVectorStore,生产环境用 Pinecone/Weaviate);
-
避坑提醒:不要将大量文档直接拼接成 Prompt 传给大模型,优先使用 RAG 方案;不要在前端暴露 Embedding 模型密钥、向量数据库地址(全部由后端处理)。